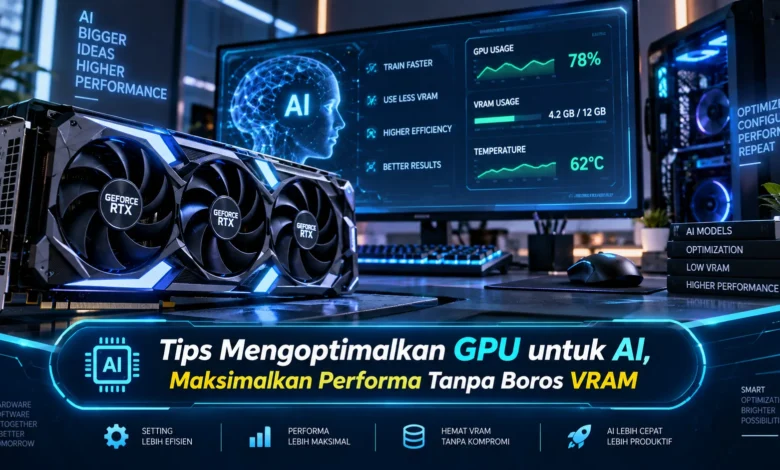
GPU menjadi salah satu komponen terpenting ketika menjalankan workload AI, baik untuk training, fine tuning, inference, maupun eksperimen model lokal. Namun, performa tinggi tidak selalu harus dibayar dengan konsumsi VRAM yang besar. Dengan konfigurasi yang tepat, pengguna dapat meningkatkan efisiensi komputasi sekaligus menjaga penggunaan memori tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI karena model modern terus bertambah kompleks sementara kapasitas perangkat keras tetap memiliki batas tertentu.
Analisis Kebutuhan Memori Sebelum Memulai Workload AI
Hal pertama dalam mengoptimalkan GPU untuk AI ialah mengetahui seberapa besar memori GPU yang dibutuhkan model. Model dengan jumlah parameter besar biasanya membutuhkan kapasitas memori lebih tinggi, khususnya ketika proses pelatihan dan fine tuning berlangsung. Dengan melakukan estimasi dari awal, pengguna dapat mengatur parameter komputasi secara lebih efisien.
Di samping jumlah parameter, batch size, panjang sequence, dimensi input, dan format numerik juga berpengaruh terhadap kebutuhan memori. Makin besar jumlah data yang diproses secara bersamaan, konsumsi memori GPU pun dapat meningkat. Karena itu, beban komputasi sebaiknya dirancang sesuai kapasitas VRAM agar performa TEKNOLOGI AI tetap optimal tanpa menyebabkan kehabisan memori.
Kurangi Konsumsi Memori dengan Mixed Precision
Salah satu cara paling efektif dalam menekan konsumsi memori GPU adalah menggunakan precision yang lebih rendah. Format seperti FP16 atau BF16 dapat mengurangi kebutuhan memori dibandingkan FP32, tanpa mengorbankan performa secara signifikan di perangkat GPU generasi baru.
Mixed precision training juga dapat menjadi pilihan menarik karena sebagian operasi dijalankan dengan precision rendah sementara proses tertentu tetap menggunakan precision lebih tinggi. Strategi tersebut membantu meningkatkan throughput dan tetap menjaga konsumsi VRAM lebih terkendali. Pada perkembangan TEKNOLOGI kecerdasan buatan saat ini, pengelolaan precision menjadi bagian penting dari strategi optimasi GPU.
Atur Batch Size agar Performa dan Memori Tetap Seimbang
Batch size memiliki pengaruh besar terhadap konsumsi VRAM. Ukuran batch yang berlebihan dapat membebani memori GPU dengan cepat, sementara batch yang terlalu kecil dapat menurunkan efisiensi GPU. Kompromi antara efisiensi dan kapasitas perlu dicari berdasarkan kemampuan perangkat.
Jika kapasitas VRAM terbatas, pengguna dapat memanfaatkan gradient accumulation untuk memperoleh hasil serupa dengan batch besar tanpa memasukkan semua sampel sekaligus ke VRAM. Teknik tersebut menjalankan komputasi dalam beberapa tahap, lalu mengakumulasi gradien sebelum optimizer bekerja. Dengan cara ini, proses training tetap dapat berjalan efektif meski kapasitas VRAM terbatas.
Gunakan Quantization untuk Menjalankan Model Besar Lebih Efisien
Quantization menjadi salah satu teknik populer untuk menjalankan model AI dengan konsumsi memori lebih rendah. Melalui pengurangan precision pada bobot model, misalnya dari 16 bit menjadi 8 bit atau 4 bit, kapasitas memori yang dibutuhkan model bisa turun drastis.
Strategi pengurangan precision ini sangat berguna untuk inference dan menjalankan large language model secara lokal. Arsitektur yang semula terlalu berat untuk GPU tertentu berpotensi dimuat pada perangkat dengan kapasitas VRAM yang lebih kecil. Walaupun begitu, penggunaan quantization tetap perlu disesuaikan dengan kebutuhan karena pengurangan bit yang terlalu agresif dapat memengaruhi kualitas output.
Kelola Cache dan Memori GPU Secara Lebih Efisien
Beban VRAM bukan hanya berasal dari parameter AI, tetapi juga dari cache, tensor sementara, activation, serta proses lain yang berjalan bersamaan. Karena itu, pengguna perlu memantau penggunaan GPU secara berkala agar tidak ada aplikasi lain yang menggunakan VRAM tanpa kebutuhan.
Melepaskan alokasi memori yang sudah selesai digunakan bisa memberikan ruang VRAM tambahan bagi proses AI selanjutnya. Di samping itu, menghentikan software lain yang memanfaatkan akselerasi grafis bisa membebaskan sebagian kapasitas memori grafis. Manajemen seperti ini mungkin tampak sederhana namun cukup berpengaruh khususnya untuk GPU kelas menengah.
Pembaruan Driver dan Framework Penting untuk Optimalisasi GPU
Kemampuan GPU tidak semata ditentukan oleh spesifikasi fisik, tetapi turut bergantung pada optimasi driver, library komputasi, dan software yang digunakan. Driver grafis yang tepat dapat membantu memastikan workload AI berjalan secara optimal, terutama ketika menggunakan framework AI terbaru.
Framework machine learning generasi baru biasanya menyediakan berbagai teknik optimasi termasuk mekanisme attention efisien, kernel khusus, dan pemrosesan yang lebih terintegrasi. Menjaga lingkungan perangkat lunak tetap optimal dapat menghasilkan peningkatan performa tanpa harus mengganti GPU. Karena itu, optimalisasi software sama pentingnya dengan memilih kartu grafis yang kuat.
Kesimpulan
Mengoptimalkan GPU untuk AI bukan hanya soal menggunakan kartu grafis dengan VRAM terbesar. Kombinasi mixed precision, batch yang tepat, quantization, manajemen memori, dan konfigurasi framework mampu membantu GPU bekerja jauh lebih efektif. Dengan strategi yang tepat, workload AI dapat berjalan lebih stabil meski kapasitas VRAM memiliki keterbatasan.
Perkembangan TEKNOLOGI AI terus mendorong hadirnya metode komputasi yang semakin efisien. Dengan demikian, pengguna sebaiknya tidak hanya mengejar spesifikasi hardware, namun juga memperhatikan pengaturan model, framework, dan penggunaan memori. Melalui pengelolaan yang tepat, performa AI dapat dimaksimalkan tanpa membuat VRAM terbuang sia sia. Pembaca dapat terus mengeksplorasi berbagai metode optimasi GPU untuk menemukan konfigurasi yang paling sesuai dengan model dan perangkat yang digunakan.