AI Inference Engine Optimization 2026 Jadi Kunci Mempercepat Pemrosesan AI di Perangkat Modern

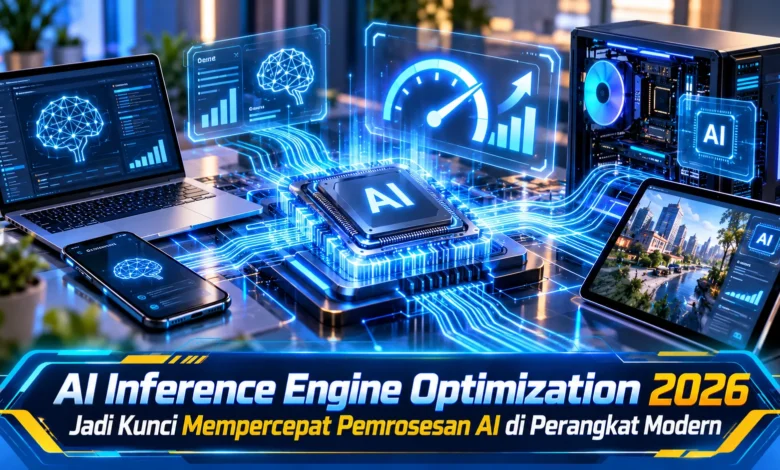
Perkembangan kecerdasan buatan pada 2026 tidak hanya berfokus pada pembuatan model yang semakin canggih, tetapi juga pada bagaimana model tersebut dapat dijalankan secara cepat dan efisien. AI Inference Engine Optimization menjadi bagian penting karena proses inference menentukan seberapa cepat perangkat menghasilkan respons setelah menerima input. Optimalisasi pada tahap ini semakin relevan ketika teknologi AI hadir di smartphone, laptop, kendaraan, perangkat wearable, kamera pintar, hingga berbagai perangkat edge yang membutuhkan respons cepat dengan konsumsi daya tetap terkendali.
Memahami Cara Kerja AI Inference Engine Optimization
AI Inference Engine Optimization menjadi pendekatan untuk meningkatkan efisiensi ketika model AI digunakan menghasilkan prediksi atau respons. Ketika model telah melalui tahap training, proses inference dilakukan setiap kali sistem menerima masukan baru. Tahap inilah yang menentukan seberapa cepat teknologi AI dapat menghasilkan keluaran yang dibutuhkan pengguna.
Optimalisasi inference bukan sekadar usaha untuk membuat pemrosesan berlangsung lebih cepat. Pengembang juga perlu mempertimbangkan penggunaan memori, konsumsi energi, latensi, kapasitas perangkat, serta karakteristik hardware yang tersedia. Keseimbangan berbagai faktor tersebut penting karena model yang sangat cepat belum tentu ideal apabila membutuhkan daya atau memori terlalu besar.
Pemrosesan AI Real Time Membutuhkan Inference yang Efisien
Semakin banyak fitur AI yang berjalan langsung pada perangkat membuat kecepatan inference menjadi semakin penting. Berbagai fitur mulai dari pengolahan visual, penerjemahan, pengenalan audio, pembuatan konten, asisten pintar, hingga analisis sensor membutuhkan pemrosesan yang responsif. Jika proses inference terlalu lambat, pengguna dapat merasakan jeda yang mengurangi kenyamanan ketika berinteraksi dengan perangkat.
Performa inference sangat menentukan sistem yang membutuhkan pengambilan keputusan dalam waktu singkat. Perangkat pintar dapat menerima aliran data dari kamera, mikrofon, sensor gerak, atau komponen lain secara terus menerus. Inference engine yang dioptimalkan membantu memproses informasi tersebut dengan latensi lebih rendah sehingga teknologi dapat memberikan respons secara lebih cepat.
Quantization Membantu Mengurangi Beban Komputasi Model
Salah satu pendekatan yang dapat digunakan untuk mengoptimalkan inference adalah quantization. Teknik tersebut bekerja dengan menggunakan representasi angka berpresisi lebih rendah sehingga penggunaan memori maupun beban komputasi dapat ditekan. Jika diterapkan secara tepat, model dapat memiliki ukuran dan kebutuhan komputasi lebih rendah sambil tetap mempertahankan fungsi yang diperlukan.
Namun, penggunaan presisi yang lebih rendah perlu dievaluasi karena tingkat optimalisasi yang terlalu agresif dapat memengaruhi kualitas hasil model. Optimalisasi perlu mempertimbangkan kompromi antara ukuran model, waktu pemrosesan, kebutuhan energi, dan kualitas hasil. Oleh sebab itu, evaluasi langsung pada hardware tujuan menjadi tahapan penting sebelum teknologi diterapkan lebih luas.
Hardware Accelerator Membantu Mempercepat Eksekusi AI
Optimalisasi perangkat lunak dapat memberikan hasil lebih baik ketika disesuaikan dengan kemampuan hardware yang tersedia. Perangkat modern dapat memiliki CPU, GPU, NPU, maupun akselerator khusus yang memiliki karakteristik berbeda dalam menjalankan beban kerja AI. Mesin inference perlu mengatur pembagian operasi sehingga komponen hardware dapat digunakan secara efektif.
NPU menjadi semakin relevan karena dirancang untuk menangani berbagai operasi AI dengan efisiensi yang lebih baik pada perangkat tertentu. Meski demikian, kinerja keseluruhan masih dipengaruhi model, mesin inference, driver, compiler, sistem memori, serta integrasi setiap komponen. Hal tersebut membuat optimalisasi teknologi AI perlu dilakukan melalui integrasi software dan hardware, bukan hanya menggunakan satu komponen yang kuat.
Inference Engine Efisien Mendukung Pertumbuhan On Device AI
Pemrosesan AI secara lokal menawarkan manfaat seperti respons yang cepat dan kebutuhan koneksi cloud yang lebih rendah untuk beberapa fungsi. Meski demikian, smartphone, laptop, perangkat wearable, dan sistem edge tetap memiliki batas energi serta pengelolaan temperatur. Proses inference yang membutuhkan sumber daya besar dapat menguras baterai dan meningkatkan temperatur perangkat sehingga kenyamanan berkurang.
AI Inference Engine Optimization berusaha mengurangi operasi yang tidak diperlukan sekaligus memanfaatkan hardware dengan cara yang lebih efisien. Teknik seperti pengelolaan memori yang lebih baik, optimasi graph, penggabungan operasi, quantization, serta penjadwalan komputasi dapat membantu meningkatkan efisiensi. Tujuannya adalah menghadirkan teknologi AI dengan respons yang cepat sambil mempertahankan penggunaan sumber daya yang terkontrol.
Optimalisasi Model dan Inference Engine Harus Berjalan Bersama
Kecepatan pemrosesan kecerdasan buatan tidak hanya berasal dari spesifikasi hardware. Desain model, tipe operasi, skala parameter, representasi data, sistem memori, compiler, dan runtime dapat memengaruhi kecepatan inference. Karena itu, optimalisasi yang efektif biasanya mempertimbangkan keseluruhan jalur pemrosesan dari model hingga hardware.
Pengembang dapat menyesuaikan model berdasarkan karakteristik perangkat yang menjadi target penggunaan. Model untuk server berkapasitas tinggi dapat menggunakan konfigurasi berbeda dari model yang dirancang bagi smartphone maupun wearable. Strategi berbasis karakteristik perangkat dapat membantu menyeimbangkan kualitas keluaran, performa, kebutuhan daya, serta kapasitas memori.
Kesimpulan
AI Inference Engine Optimization 2026 menjadi bagian penting dalam perkembangan AI karena kemampuan model yang tinggi perlu didukung proses eksekusi yang cepat dan efisien. Teknik seperti quantization, optimalisasi memori, penyederhanaan graph, penggabungan operasi, peningkatan compiler, runtime, dan akselerasi hardware dapat membantu mempercepat inference. Peran inference yang efisien semakin besar ketika teknologi kecerdasan buatan hadir langsung di smartphone, komputer, wearable, kendaraan, serta berbagai perangkat edge. Melalui integrasi model, software, serta hardware yang tepat, perangkat dapat menjalankan AI secara lebih responsif tanpa mengabaikan penggunaan energi. Pembaca dapat terus mengikuti perkembangan teknologi inference berikutnya dan mengamati bagaimana optimalisasi ini memengaruhi kemampuan AI pada perangkat yang digunakan sehari hari.