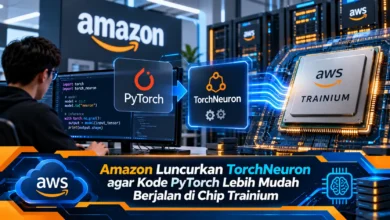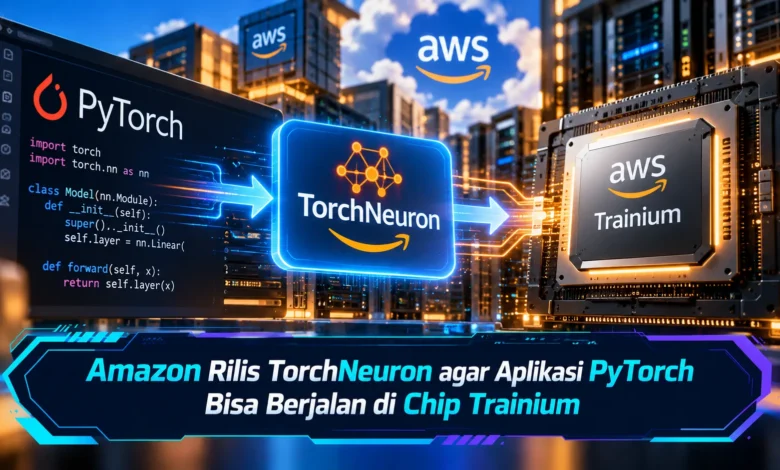
Amazon memperkenalkan TorchNeuron pada 19 Oktober 2026 sebagai langkah penting dalam memperluas penggunaan chip kecerdasan buatan AWS Trainium. Perangkat lunak ini memungkinkan pengembang menjalankan aplikasi dan model AI berbasis PyTorch pada chip Trainium tanpa harus menulis ulang sebagian besar kode yang sudah digunakan. TorchNeuron hadir dalam versi beta publik pada 20 Oktober 2026 dengan lisensi sumber terbuka Apache 2.0. Inovasi TEKNOLOGI ini menjadi perhatian karena berpotensi mengurangi ketergantungan pengembang terhadap satu platform perangkat keras. Selain membuka pilihan infrastruktur komputasi AI, Amazon juga ingin mempermudah perusahaan mengoptimalkan biaya dan meningkatkan fleksibilitas pengembangan kecerdasan buatan.
Mengenal TorchNeuron dan Inovasi Terbaru Amazon AWS
Amazon mengembangkan TorchNeuron sebagai backend native untuk framework PyTorch yang dirancang untuk mendukung pengembangan kecerdasan buatan pada chip Trainium. Dengan memanfaatkan sistem ini, pengembang memiliki kesempatan menggunakan model AI yang telah dikembangkan pada perangkat keras akselerator milik Amazon dengan perubahan kode yang minimal. Tidak seperti pendekatan migrasi yang memerlukan penulisan ulang banyak komponen, TorchNeuron menggunakan mekanisme ekstensi resmi PyTorch agar chip Amazon dapat digunakan melalui antarmuka standar. Integrasi tersebut memberikan fleksibilitas tambahan bagi peneliti AI.
Pengembang platform cloud Amazon menghadirkan TorchNeuron menjelang PyTorch Conference North America yang digunakan untuk memperkenalkan teknologi ini kepada komunitas pengembang. Perangkat lunak tersebut mulai dapat digunakan dalam tahap pengujian publik pada 20 Oktober 2026 dengan lisensi Apache 2.0. Pilihan distribusi sumber terbuka ini memberikan ruang untuk kontribusi komunitas sesuai persyaratan penggunaan perangkat lunak terbuka. TorchNeuron sendiri dapat digunakan pada infrastruktur berbasis Trainium2 maupun Trainium3. Berkat kompatibilitas tersebut, Amazon ingin mengurangi hambatan penerapan chip AI miliknya tanpa membangun ulang alur kerja dari awal.
Teknologi Backend PyTorch yang Mendukung Chip AWS Trainium
Mekanisme utama perangkat lunak ini mengandalkan infrastruktur backend PyTorch yang disebut PrivateUse1. Komponen perangkat lunak tersebut memungkinkan pendaftaran perangkat keras tambahan tanpa mengharuskan perubahan besar pada PyTorch. Berkat integrasi tersebut, chip Trainium dapat diakses menggunakan identitas perangkat neuron. Pengembang kemudian, dapat mengarahkan model ke perangkat tersebut melalui pengaturan perangkat dalam aplikasi. Integrasi semacam ini mendukung penggunaan API PyTorch yang sudah dikenal ketika mengembangkan aplikasi pembelajaran mesin.
Tidak hanya menghadirkan integrasi perangkat, TorchNeuron menyediakan dua mode pemrosesan utama, yaitu eager execution dan torch.compile. Dalam eksekusi eager, operasi PyTorch berlangsung mengikuti alur kode program sehingga pengembang lebih mudah melakukan debugging. Untuk kebutuhan performa produksi, torch.compile membantu meningkatkan efisiensi eksekusi model. Sebagai pelengkap, sistem ini mengintegrasikan kemampuan pemrograman melalui Neuron Kernel Interface atau NKI. Komponen pengembangan tersebut memberikan kendali lebih mendalam terhadap bagian aplikasi yang membutuhkan performa tinggi. Berkat fleksibilitas ini, pengguna dapat menyesuaikan strategi pengembangan berdasarkan kebutuhan penelitian atau produksi.
Integrasi PyTorch dengan Transformers serta Distributed Training
Salah satu aspek penting dari TorchNeuron adalah integrasinya dengan ekosistem perangkat lunak AI. Platform Hugging Face menjadi bagian dari dukungan tersebut. Melalui integrasi ini, pustaka Transformers dan Diffusers memiliki jalur penggunaan menuju akselerator Amazon. Framework Transformers menjadi komponen penting dalam pengembangan model generatif, sedangkan Diffusers membantu menjalankan berbagai arsitektur generasi gambar dan media. Dalam kebutuhan komputasi berskala besar, TorchNeuron memanfaatkan mekanisme pembagian komputasi seperti Fully Sharded Data Parallelism dan tensor parallelism. Dukungan ini membantu menangani model yang lebih besar pada lingkungan komputasi dengan banyak chip.
Kendati integrasi ekosistem semakin berkembang, TorchNeuron masih memiliki keterbatasan pada operasi tertentu. Dalam dokumentasi teknis, sejumlah fitur PyTorch belum tersedia pada backend tersebut. Di antara keterbatasan yang disebutkan meliputi komputasi menggunakan representasi tensor jarang, NestedTensor, serta dukungan dynamic shapes tertentu. Di samping keterbatasan tersebut, operasi yang tidak tersedia secara langsung pada backend berpotensi menggunakan fallback ke CPU. Dengan mempertimbangkan kondisi tersebut, pengguna dianjurkan membaca dokumentasi dukungan terbaru sebelum mengadopsi Trainium dalam skala besar. Evaluasi kompatibilitas membantu mengurangi risiko gangguan secara lebih realistis.
Keunggulan AWS Trainium untuk Efisiensi Komputasi AI
Keuntungan penting dari kehadiran TorchNeuron adalah kemudahan mengevaluasi alternatif akselerator. Sebelumnya, aplikasi yang dioptimalkan pada perangkat keras khusus dapat membutuhkan penyesuaian pustaka ketika menggunakan arsitektur komputasi baru. Dengan TorchNeuron, pengembang berpeluang menggunakan alur kerja yang sudah dikenal. Hal ini membantu menyederhanakan evaluasi perangkat keras. Meski menawarkan kemudahan, penggunaan pada sistem produksi tetap membutuhkan pengujian performa. Melalui tahapan evaluasi yang benar, perusahaan berpeluang memilih solusi komputasi yang lebih sesuai.
Dari sisi biaya, AWS Trainium dirancang untuk mendukung kebutuhan komputasi kecerdasan buatan. Ketersediaan backend PyTorch native dapat mempermudah proses evaluasi biaya antara Trainium dan perangkat keras lainnya. Penghematan yang mungkin diperoleh tetap bergantung pada karakteristik pekerjaan. Aspek perhitungan penting mencakup tarif sumber daya komputasi, durasi komputasi, pemanfaatan akselerator, serta pengeluaran operasional pendukung. Untuk perusahaan yang menjalankan model besar, harga komputasi yang lebih kompetitif belum tentu menghasilkan total biaya paling kecil apabila proses eksekusinya lebih lama. Oleh sebab itu, pengujian berdasarkan beban kerja sesungguhnya harus dilakukan sebelum mengambil keputusan.
Cara Memulai Penggunaan TorchNeuron pada AWS Trainium
Bagi pengguna yang tertarik menggunakan backend baru ini sebaiknya memastikan akses ke infrastruktur Trainium dengan instans AWS berbasis Trainium generasi yang sesuai. Selain perangkat keras, pengguna harus menyesuaikan versi pustaka pengembangan dengan rilis AWS Neuron yang sedang digunakan. TorchNeuron tersedia melalui paket torch-neuronx dari repositori paket AWS Neuron. Proses instalasi harus disesuaikan dengan dokumentasi sistem karena kombinasi paket menentukan keberhasilan instalasi. Ketika semua dependensi tersedia, pengembang dapat mulai memindahkan model ke perangkat neuron dan mengevaluasi keberhasilan eksekusi awal.
Tahap pengujian awal dianjurkan mengevaluasi fungsi utama model sebelum melakukan optimasi performa lanjutan. Tim teknis bisa menguji hasil inferensi antara akselerator lama dan Trainium. Di samping pemeriksaan akurasi, TorchNeuron memiliki fasilitas pemeriksaan jalur eksekusi bersama Neuron Explorer. Berkat dukungan analisis performa, pengembang mampu mengidentifikasi bagian program yang kurang efisien. Data pemantauan tersebut dapat digunakan untuk memperbaiki kinerja. Untuk sistem AI berskala besar, pengujian memori, pengelolaan distribusi komputasi, dan evaluasi konsumsi sumber daya tetap menjadi bagian penting.
Kesimpulan tentang TorchNeuron dan Masa Depan Chip AI Amazon
Diperkenalkannya backend TorchNeuron menjadi perkembangan penting dalam pengembangan komputasi AI berbasis cloud. Berkat pengembangan backend native PyTorch untuk Trainium2 dan Trainium3, Amazon membuka pilihan penggunaan perangkat keras ketika mengembangkan aplikasi kecerdasan buatan. Dukungan eager execution, torch.compile, serta kompatibilitas dengan berbagai pustaka AI memperluas peluang penerapan. Kendati memiliki potensi besar, evaluasi performa tetap diperlukan sebelum penggunaan skala besar. Seiring meningkatnya kebutuhan komputasi AI, TorchNeuron dapat mendorong interoperabilitas perangkat keras. Menurut Anda, apakah kemudahan menjalankan PyTorch pada Trainium akan mendorong adopsi infrastruktur yang lebih beragam? Sampaikan pandangan Anda mengenai persaingan teknologi komputasi kecerdasan buatan.